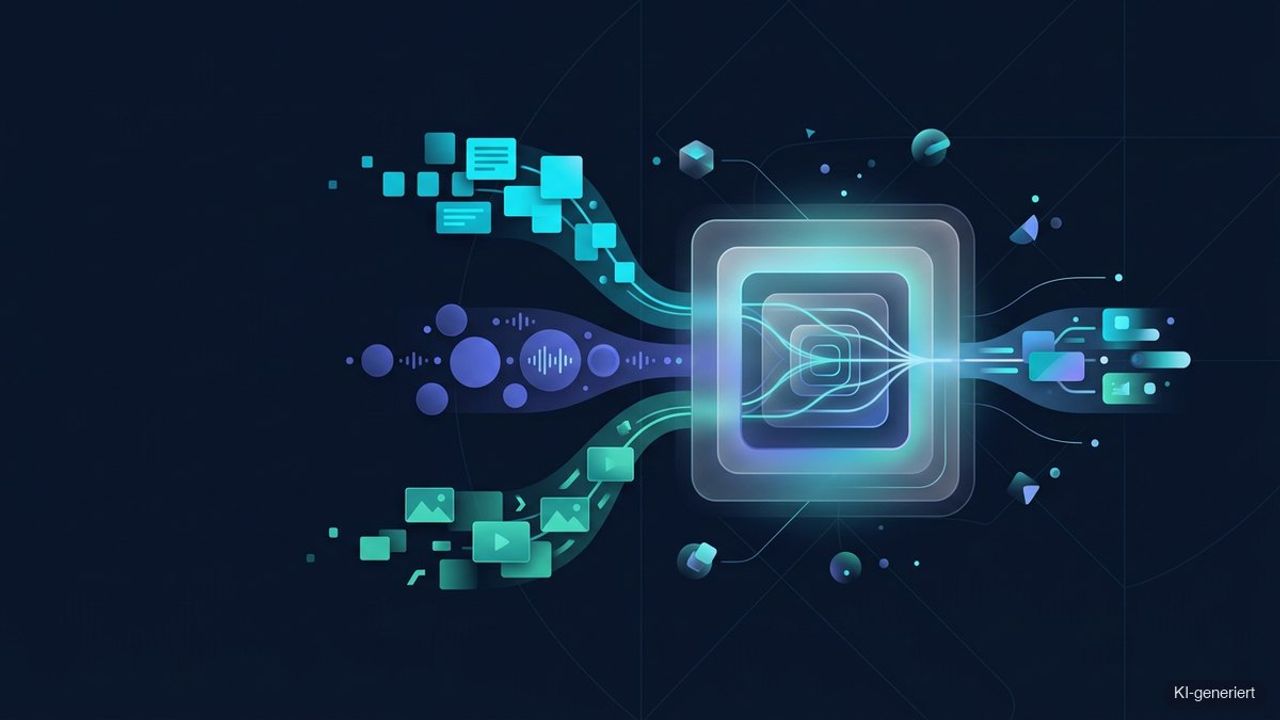
Multimodale KI bezeichnet KI-Systeme, die mehrere Arten von Daten gleichzeitig verarbeiten können, etwa Text, Bilder, Audio und Video. Anders als rein textbasierte Modelle können multimodale Systeme zum Beispiel ein Bild beschreiben, Fragen zu einer Grafik beantworten oder Text und Bild kombiniert auswerten. Sie bilden die Grundlage vieler moderner KI-Assistenten.
Was ist multimodale KI?
Multimodale KI bezeichnet KI-Systeme, die mehrere Arten von Daten gleichzeitig verarbeiten können, etwa Text, Bilder, Audio und Video. Anders als rein textbasierte Modelle können multimodale Systeme zum Beispiel ein Bild beschreiben, Fragen zu einer Grafik beantworten oder Text und Bild kombiniert auswerten. Sie bilden die Grundlage vieler moderner KI-Assistenten und erweitern den Anwendungsraum der künstlichen Intelligenz erheblich.
Der Begriff „Modalität“ meint dabei die Art der Daten: Sprache, Bild, Ton oder bewegte Bilder sind jeweils eigene Modalitäten. Ein multimodales Modell verknüpft diese, statt sie isoliert zu behandeln. Der englische Wikipedia-Artikel zum multimodalen Lernen beschreibt, wie Modelle darauf trainiert werden, Zusammenhänge zwischen verschiedenen Datenarten herzustellen.
Multimodale Fähigkeiten sind heute ein Kernmerkmal führender Systeme. Ein modernes Large Language Model verarbeitet oft nicht nur Text, sondern auch hochgeladene Bilder oder Dokumente. Damit verschwimmt die Grenze zwischen reiner Textverarbeitung und der generativen KI, die Inhalte über mehrere Modalitäten hinweg erzeugt.
Wie funktioniert multimodale KI?
Multimodale Modelle wandeln unterschiedliche Datenarten in eine gemeinsame interne Darstellung um, sodass das System Text, Bild oder Ton in einem geteilten Bedeutungsraum verarbeiten kann. Diese Repräsentation nennt man auch Embedding: Inhalte verschiedener Modalitäten werden als Vektoren abgebildet, die inhaltliche Nähe geometrisch ausdrücken. Dadurch lässt sich ein Bild mit Text in Beziehung setzen oder eine gesprochene Frage zu einem Dokument beantworten.
Technisch bauen viele multimodale Systeme auf der Transformer-Architektur auf und werden mit Datensätzen trainiert, die verschiedene Modalitäten verknüpfen, etwa Bilder mit Bildbeschreibungen. Der Wikipedia-Artikel zum Transformer erläutert das zugrunde liegende Architekturprinzip, das auch reine Sprachmodelle antreibt. So lernt das Modell Zusammenhänge zwischen den Modalitäten.
Nutzer können dann etwa ein Foto hochladen und dazu Fragen in natürlicher Sprache stellen. Assistenten wie ChatGPT, Google Gemini oder Claude verarbeiten Text und Bild in einem Dialog. Grundlage all dessen sind Verfahren des Machine Learnings und tiefe neuronale Netze, die auf großen, gemischten Datenmengen trainiert wurden.
Für Anwender ist entscheidend, dass diese gemeinsame Verarbeitung neue, intuitivere Interaktionsformen ermöglicht. Man muss nicht mehr alles in Worte fassen, sondern kann ein Bild zeigen und dazu fragen, ein Dokument hochladen und um eine Zusammenfassung bitten oder eine Skizze in Text übersetzen lassen. Diese Natürlichkeit senkt die Hürde, KI-Werkzeuge im Arbeitsalltag tatsächlich zu nutzen.
Wo wird multimodale KI eingesetzt?
Multimodale KI ermöglicht Anwendungen wie Bildbeschreibung, Dokumentenanalyse mit Grafiken, Sprachassistenten mit visuellem Verständnis und die kombinierte Erstellung von Text und Bild. Im Marketing lässt sich damit etwa Bildmaterial automatisch beschreiben, aus Skizzen Text ableiten oder visueller Content analysieren — eine Brücke zwischen der KI-Bildgenerierung und der Texterstellung.
Für Kanzleien und Unternehmen kann multimodale KI beim Auswerten gescannter Dokumente, beim Erstellen von Bildunterschriften oder bei der Analyse von Präsentationen helfen. Ein praktischer Nebeneffekt ist die barrierefreie Aufbereitung: Aus Bildern lassen sich automatisch Alt-Texte erzeugen, die sehbehinderten Nutzern den Inhalt zugänglich machen. Auch bei der Produktion von KI-Content spielt die Kombination von Text und Bild eine wachsende Rolle.
Wie bei allen KI-Systemen gilt: Sensible Daten sind mit Vorsicht zu behandeln und Ergebnisse sollten überprüft werden, da auch multimodale Modelle Fehler machen. Weil sie mehrere Datenarten verarbeiten, steigen die Anforderungen an den Datenschutz zusätzlich — etwa wenn Bilder erkennbare Personen zeigen.
Warum ist multimodale KI wichtig?
Die Kombination mehrerer Datenarten macht KI vielseitiger und näher an der Art, wie Menschen Informationen aufnehmen. Statt nur Text zu verarbeiten, können Systeme visuelle und akustische Zusammenhänge einbeziehen, was neue Anwendungsfelder eröffnet. Der Wikipedia-Artikel zur künstlichen Intelligenz ordnet diese Entwicklung in die breitere KI-Geschichte ein.
Für das Marketing wächst damit die Bandbreite an Automatisierungsmöglichkeiten, von der Bildanalyse bis zur barrierefreien Aufbereitung von Inhalten. Verfahren des Natural Language Processing verbinden sich mit Bildverstehen zu Werkzeugen, die ganze Content-Prozesse unterstützen — vom ersten Entwurf bis zur finalen Ausspielung.
Zugleich steigen die Anforderungen an Datenschutz und Sorgfalt, weil mehr Datenarten verarbeitet werden. Multimodale Systeme sind mächtig, aber nicht unfehlbar; ihre Ergebnisse brauchen menschliche Kontrolle. Wer sie einsetzt, sollte Chancen und Grenzen gleichermaßen kennen und die Ausgaben stets kritisch prüfen.
Zugleich sollte man die Erwartungen realistisch halten: Die Qualität multimodaler Ergebnisse schwankt je nach Aufgabe und Datenlage erheblich. Bei gut abgedeckten, alltäglichen Motiven sind die Systeme überzeugend, bei speziellen Fachinhalten oder ungewöhnlichen Bildern häufiger unzuverlässig. Ein prüfender Blick auf die Ausgabe bleibt deshalb in professionellen Kontexten unverzichtbar.
Multimodale KI und generative Anwendungen
Multimodale Fähigkeiten sind eng mit der generativen KI verwoben. Systeme, die Bild und Text gemeinsam verstehen, können auch beides erzeugen — etwa aus einer Textbeschreibung ein Bild oder aus einem Bild eine Bildunterschrift. Die generative künstliche Intelligenz treibt damit viele der Anwendungen an, die multimodale Modelle im Alltag sichtbar machen.
Für die Praxis eröffnet das durchgängige Content-Prozesse: Ein Modell kann einen Text entwerfen, dazu passende Bildideen liefern und über die KI-Videogenerierung sogar bewegte Inhalte anstoßen. Auch die KI-Übersetzung profitiert, wenn ein System Text im Kontext von Bildern und Layout versteht statt isoliert Wort für Wort.
Technisch bauen diese Fähigkeiten auf tiefen Netzen und dem Deep Learning auf, das Muster über sehr große, gemischte Datenmengen lernt. Die Qualität hängt stark von den Trainingsdaten ab — was auch erklärt, warum Ergebnisse in gut abgedeckten Bereichen überzeugender ausfallen als in Nischen mit dünner Datenlage.
Grenzen und Risiken multimodaler KI
So vielseitig multimodale Systeme sind, sie bleiben fehleranfällig. Auch bei Bildern und Dokumenten können Modelle eine Halluzination produzieren — also plausible, aber falsche Aussagen, etwa eine erfundene Beschriftung oder eine fehlinterpretierte Grafik. Ergebnisse gehören deshalb geprüft, bevor sie in Kundenkommunikation oder Entscheidungen einfließen.
Beim Hochladen sensibler Inhalte ist besondere Vorsicht geboten. Weil multimodale Systeme mehr Datenarten verarbeiten, steigt das Risiko, unbeabsichtigt personenbezogene oder vertrauliche Informationen preiszugeben — etwa auf gescannten Dokumenten oder Fotos. Klare interne Regeln, welche Inhalte in welche Tools gegeben werden dürfen, sind daher unverzichtbar.
Ein konstruktiver Einsatz nutzt die Stärken und begrenzt die Risiken: Multimodale KI eignet sich hervorragend, um Entwürfe zu erstellen, Inhalte zugänglich zu machen — etwa über die Barrierefreiheit durch automatische Beschreibungen — oder große Mengen zu sichten. Die finale Verantwortung für Richtigkeit und Rechtmäßigkeit bleibt beim Menschen.
Multimodale KI im Alltag der Nutzer
Für viele Menschen wird multimodale KI zuerst über Sprache greifbar. Sprachassistenten verbinden gesprochene Anfragen mit visuellem und textlichem Verständnis und werden dadurch deutlich leistungsfähiger als klassische, rein befehlsbasierte Systeme. Die gesprochene Frage zu einem Foto ist ein typisches Beispiel für dieses Zusammenspiel.
In der Ausgabe zeigt sich die Multimodalität ebenso: Über Text-to-Speech werden geschriebene Inhalte hörbar, über Transkription gesprochene Sprache verschriftlicht. Für die barrierefreie Aufbereitung von Inhalten sind beide Richtungen wertvoll, weil sie denselben Inhalt in unterschiedlichen Modalitäten zugänglich machen.
Zunehmend fügen sich diese Fähigkeiten in autonomere Systeme ein: Ein KI-Agent kann Text, Bild und weitere Signale kombinieren, um mehrstufige Aufgaben zu bearbeiten. Damit wächst der Nutzen, aber auch die Verantwortung, Ergebnisse zu prüfen — gerade wenn mehrere Verarbeitungsschritte aufeinander aufbauen und sich Fehler fortpflanzen können.