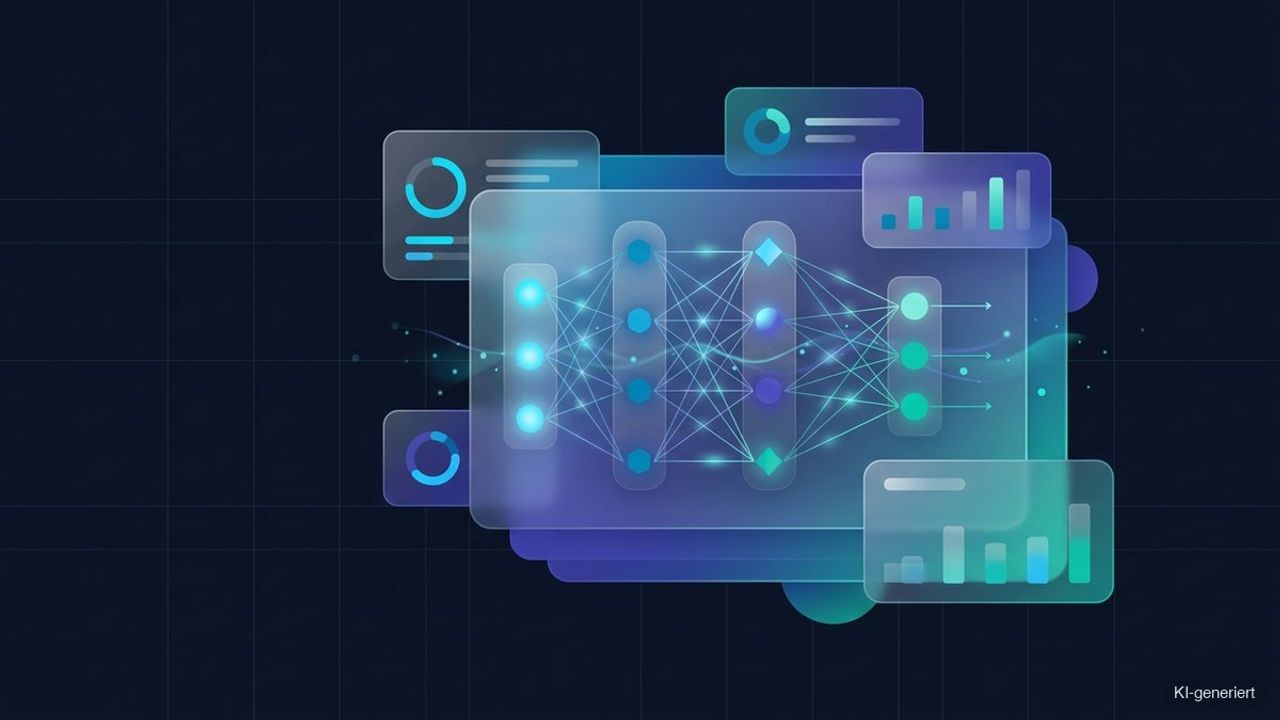
Ein neuronales Netz (englisch Neural Network) ist ein Rechenmodell, das dem Aufbau des menschlichen Gehirns nachempfunden ist. Es besteht aus vernetzten künstlichen Neuronen, die in Schichten organisiert sind und Informationen weiterleiten. Durch Training passt das Netz die Verbindungsstärken zwischen den Neuronen an und lernt so, Muster in Daten zu erkennen und Vorhersagen zu treffen.
Was ist ein neuronales Netz?
Ein neuronales Netz (englisch Neural Network) ist ein Rechenmodell, das dem Aufbau des menschlichen Gehirns nachempfunden ist. Es besteht aus vernetzten künstlichen Neuronen, die in Schichten organisiert sind und Informationen weiterleiten. Durch Training passt das Netz die Verbindungsstärken zwischen den Neuronen an und lernt so, Muster in Daten zu erkennen und Vorhersagen zu treffen. Neuronale Netze sind das technische Fundament des Deep Learning und damit vieler moderner Anwendungen der künstlichen Intelligenz.
Das Gabler Wirtschaftslexikon ordnet neuronale Netze den subsymbolischen Verfahren der KI zu: Wissen wird nicht in expliziten Regeln, sondern verteilt in den Gewichten vieler Verbindungen gespeichert. Eine ausführliche technische Darstellung bietet der Wikipedia-Artikel zum künstlichen neuronalen Netz. Neuronale Netze sind eng mit dem allgemeineren Feld des maschinellen Lernens verbunden, das die zugrunde liegenden Lernverfahren bereitstellt.
Der Vergleich mit dem Gehirn ist dabei eine Analogie, keine exakte Nachbildung. Künstliche Neuronen sind stark vereinfachte mathematische Funktionen. Ihre Stärke entsteht weniger aus der Nachahmung der Biologie als aus der schieren Zahl der Verbindungen und der Fähigkeit, aus Daten zu lernen, statt nach festen Regeln zu arbeiten.
Wie funktioniert ein neuronales Netz?
Ein neuronales Netz besteht aus einer Eingabeschicht, einer oder mehreren verborgenen Schichten und einer Ausgabeschicht. Jedes künstliche Neuron empfängt Signale, gewichtet sie, summiert sie und gibt über eine Aktivierungsfunktion ein Ergebnis weiter. Die Gewichte bestimmen, wie stark einzelne Eingaben das Ergebnis beeinflussen. Je mehr Schichten ein Netz hat, desto komplexere, nichtlineare Zusammenhänge kann es erfassen.
Beim Training werden dem Netz Beispiele aus Trainingsdaten gezeigt. Weichen die Vorhersagen vom gewünschten Ergebnis ab, werden die Gewichte über ein Verfahren namens Backpropagation angepasst. Schrittweise minimiert das Netz seinen Fehler und lernt, die zugrunde liegenden Muster abzubilden. Dieser Optimierungsprozess ist im Kern ein Algorithmus, der große Datenmengen benötigt — weshalb Datenqualität und Datenmenge über die Leistungsfähigkeit entscheiden.
Nach dem Training folgt die Anwendung, die Inferenz: Das fertige Netz verarbeitet neue, unbekannte Eingaben und liefert ein Ergebnis. Training und Anwendung sind getrennte Phasen mit sehr unterschiedlichem Ressourcenbedarf. Das Training großer Netze kann Wochen dauern und viel Rechenleistung binden, während die spätere Anwendung deutlich schlanker ist.
Welche Arten neuronaler Netze gibt es?
Neben klassischen vollvernetzten Netzen haben sich spezialisierte Architekturen etabliert. Faltungsnetze (Convolutional Neural Networks) sind auf Bilddaten ausgelegt und erkennen räumliche Muster — sie stecken hinter KI-Bildgenerierung und Objekterkennung. Rekurrente Netze verarbeiten Sequenzen wie Text oder Zeitreihen. Für die Verarbeitung natürlicher Sprache, also Natural Language Processing, war lange die schrittweise Sequenzverarbeitung maßgeblich.
Den größten Sprung brachte die Transformer-Architektur, die die Grundlage heutiger großer Sprachmodelle bildet. Sie verarbeitet Eingaben parallel und nutzt einen Aufmerksamkeitsmechanismus, um Bezüge über lange Textpassagen herzustellen. Modelle wie ChatGPT und andere Werkzeuge der generativen KI sind besonders große Transformer-Netze mit Milliarden von Parametern. Intern arbeiten sie mit sogenannten Embeddings, die Wörter und Konzepte als Vektoren abbilden.
Die Wahl der Architektur richtet sich nach der Aufgabe: Bild, Sprache, Zeitreihe oder strukturierte Daten stellen jeweils andere Anforderungen. In der Praxis werden Architekturen zunehmend kombiniert, etwa in multimodalen Systemen, die Text, Bild und Ton zugleich verarbeiten. Das erweitert das Anwendungsfeld erheblich, macht die Systeme aber auch komplexer und schwerer zu kontrollieren.
Warum sind neuronale Netze wichtig?
Neuronale Netze können komplexe, nichtlineare Zusammenhänge lernen, die sich mit klassischen Regeln kaum abbilden lassen. Dadurch haben sie Durchbrüche in Bild-, Sprach- und Textverarbeitung ermöglicht und bilden das Fundament der aktuellen KI-Entwicklung. Sie erkennen Objekte in Bildern, verarbeiten Sprache, generieren Text und steuern Empfehlungssysteme.
Für das Marketing sind neuronale Netze indirekt allgegenwärtig: Sie stecken in Werbeplattformen, die Gebote optimieren, in Suchmaschinen, die Inhalte bewerten, und in Tools zur Content-Erstellung. Ein grundlegendes Verständnis hilft, Ergebnisse einzuordnen und realistische Erwartungen an die Zuverlässigkeit solcher Systeme zu haben. Das Bundesamt für Sicherheit in der Informationstechnik informiert über Chancen und Risiken der KI, etwa im Hinblick auf Sicherheit und Robustheit.
Wer versteht, dass hinter Werbeoptimierung, Suchranking und Textgeneratoren dieselbe Grundtechnologie steht, kann Marketingentscheidungen fundierter treffen. Es wird nachvollziehbar, warum automatisierte Systeme aus Daten lernen, warum sie mit mehr und besseren Daten besser werden und warum ihre Ergebnisse dennoch nie mit vollständiger Sicherheit vorhersagbar sind.
Grenzen und Risiken
Die Stärke neuronaler Netze ist zugleich eine Herausforderung: Weil Wissen in vielen Gewichten verteilt gespeichert ist, sind Entscheidungen oft schwer nachvollziehbar — man spricht vom „Black-Box“-Problem. Für Einsatzbereiche mit rechtlicher oder fachlicher Verantwortung, etwa in Kanzleien, sollten Ergebnisse deshalb kritisch geprüft und nicht ungeprüft übernommen werden. Große Sprachmodelle neigen zudem zur Halluzination, also zur Erfindung plausibel klingender, aber falscher Aussagen.
Ein weiteres Risiko ist Verzerrung: Neuronale Netze lernen die Muster ihrer Trainingsdaten, einschließlich vorhandener Vorurteile. Bei sensiblen Anwendungen — etwa im KI-Einsatz im Kanzleimarketing — sind deshalb Datenschutz, Prüfprozesse und menschliche Kontrolle entscheidend. Auch der Ressourcenbedarf für Training und Betrieb großer Netze ist erheblich und sollte in die Bewertung einfließen.
Hinzu kommt, dass neuronale Netze kein echtes Weltwissen und kein Verständnis im menschlichen Sinne besitzen. Sie erkennen und reproduzieren statistische Muster. Das erklärt, warum sie in eng umrissenen Aufgaben brillieren, aber bei Fragen, die gesundes Urteilsvermögen oder Kontext erfordern, unzuverlässig sein können. Ein verantwortungsvoller Einsatz plant diese Grenzen von vornherein ein.
Neuronale Netze im Kontext der KI
Neuronale Netze sind ein Teilbereich des maschinellen Lernens, das wiederum unter das große Feld der künstlichen Intelligenz fällt. Nicht jede KI-Anwendung nutzt neuronale Netze, aber die spektakulärsten Fortschritte der vergangenen Jahre — von der Bilderkennung bis zu generativen Sprachmodellen — beruhen auf ihnen. Der Deep-Learning-Ansatz bezeichnet dabei den Einsatz besonders tiefer, vielschichtiger Netze.
Für Unternehmen ist weniger die technische Tiefe entscheidend als das Verständnis, was diese Systeme leisten und wo ihre Grenzen liegen. Wer neuronale Netze als leistungsfähige Mustererkenner begreift, die aus Daten lernen, aber kein echtes Weltwissen besitzen, kann ihren Einsatz im Marketing realistisch und verantwortungsvoll planen — und die Ergebnisse dort, wo es auf Richtigkeit ankommt, durch menschliche Prüfung absichern.