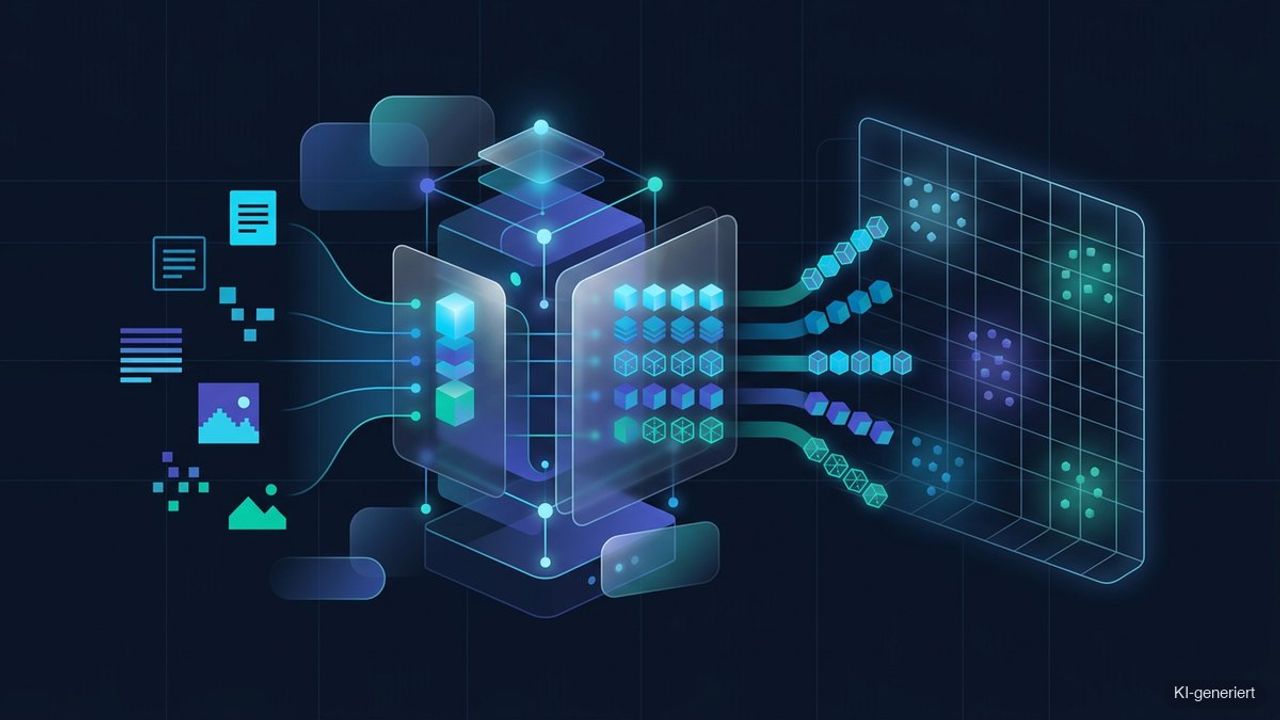
Ein Embedding (Vektor-Einbettung) ist die Darstellung von Text, Bildern oder anderen Inhalten als Zahlenreihe (Vektor), die deren Bedeutung erfasst. Inhaltlich ähnliche Elemente erhalten ähnliche Vektoren und liegen im mathematischen Raum nah beieinander. Embeddings sind die Grundlage semantischer Suche, von Empfehlungssystemen und von Verfahren wie Retrieval Augmented Generation.
Was ist ein Embedding?
Ein Embedding (Vektor-Einbettung) ist die Darstellung von Text, Bildern oder anderen Inhalten als Zahlenreihe (Vektor), die deren Bedeutung erfasst. Inhaltlich ähnliche Elemente erhalten ähnliche Vektoren und liegen im mathematischen Raum nah beieinander. Embeddings sind die Grundlage semantischer Suche, von Empfehlungssystemen und von Verfahren wie Retrieval Augmented Generation. Für Text spricht man auch von Worteinbettungen.
Der Begriff stammt aus dem Machine Learning und ist eine der stillen Schlüsseltechniken hinter modernen KI-Anwendungen. Ohne Embeddings gäbe es weder gute KI-Suche noch verlässliche Wissensanbindung von Chatbots. Die zugrunde liegenden Modelle sind spezialisierte neuronale Netze.
Wie funktioniert ein Embedding?
Ein spezialisiertes KI-Modell wandelt einen Text in eine lange Zahlenreihe um, oft mit hunderten oder tausenden Werten. Diese Zahlen kodieren die Bedeutung des Inhalts, nicht seine reine Buchstabenfolge. Die Sätze „Anwalt für Arbeitsrecht” und „Rechtsbeistand bei Kündigung” liegen deshalb nah beieinander, obwohl sie kaum gemeinsame Wörter haben. Grundlage dafür ist Deep Learning auf großen Textmengen.
Die Ähnlichkeit zweier Embeddings lässt sich mathematisch berechnen, etwa über den Abstand oder den Winkel zwischen den Vektoren. So kann ein System zu einer Suchanfrage die inhaltlich passendsten Dokumente finden, auch wenn die exakten Suchwörter fehlen. Die offizielle OpenAI-Dokumentation beschreibt, wie sich Embeddings praktisch erzeugen und nutzen lassen.
Technisch entstehen Embeddings, indem ein trainiertes Modell Muster aus riesigen Datenmengen gelernt hat, welche Wörter und Sätze in ähnlichen Zusammenhängen auftreten. Aus diesen Mustern leitet es ab, welche Inhalte einander bedeutungsmäßig nahestehen — ganz ohne eine explizit hinterlegte Bedeutungsdefinition.
Wofür werden Embeddings genutzt?
Der wichtigste Anwendungsfall ist die semantische Suche: Statt nur nach Stichwörtern zu suchen, findet das System inhaltlich passende Treffer. Das ist die Basis für die abrufgestützte Generierung (RAG), bei der relevante Textstellen zu einer Frage abgerufen und dem Sprachmodell als Kontext übergeben werden. Verwaltet werden die Vektoren dafür in einer Vektordatenbank, die auf schnelle Ähnlichkeitssuche ausgelegt ist.
Darüber hinaus stützen Embeddings Empfehlungssysteme, die Klassifikation von Inhalten (etwa Spam-Erkennung), die automatische Verschlagwortung und das Clustering ähnlicher Dokumente. Auch Dublettenerkennung und Themenanalyse großer Textmengen beruhen auf demselben Prinzip. Weil Embeddings verschiedene Inhaltstypen abbilden können, sind sie ein Baustein multimodaler KI.
Der Charme von Embeddings liegt darin, dass sie Bedeutung berechenbar machen. Zwei Texte lassen sich nicht nur als gleich oder verschieden einstufen, sondern als mehr oder weniger ähnlich — mit einem konkreten Zahlenwert. Genau das ermöglicht Rangfolgen, Empfehlungen und die gezielte Auswahl der passendsten Inhalte.
Embeddings in der Marketing-Praxis
Im Marketing ermöglichen Embeddings eine intelligente interne Suche, die auch dann passende Seiten findet, wenn Nutzer andere Wörter verwenden als die Redaktion. Für die Content-Strategie lassen sich mit Embeddings inhaltliche Lücken und Überschneidungen im eigenen Bestand aufdecken, etwa doppelte Themen oder verwaiste Seiten.
Praktisch relevant ist die Anbindung eigener Inhalte an einen KI-Chatbot für Websites: Die Website wird in Abschnitte zerlegt, als Embeddings gespeichert und bei jeder Frage nach Ähnlichkeit durchsucht. So antwortet der Bot auf Basis geprüfter eigener Inhalte. Die Qualität hängt dabei stark von der Datenqualität und dem sinnvollen Zuschnitt der Textabschnitte ab.
In der Suche auf einer Website zeigt sich der Nutzen unmittelbar: Ein Besucher, der nach einer Umschreibung sucht, findet dennoch die richtige Seite, weil das System die Bedeutung vergleicht statt nur die Buchstaben. Das senkt Absprünge und führt Nutzer schneller zum Ziel.
Grenzen und typische Fehler
Embeddings bilden Bedeutung ab, wie sie in den Trainingsdaten angelegt ist — mit allen Verzerrungen. Enthalten die Daten Vorurteile, kann sich das als KI-Bias in den Vektoren niederschlagen. Zudem sind Embeddings modellabhängig: Vektoren aus unterschiedlichen Modellen sind nicht vergleichbar, weshalb man innerhalb eines Systems bei einem Modell bleiben sollte.
Ein häufiger Fehler ist der falsche Zuschnitt der Textabschnitte: Zu große Blöcke verwässern die Ähnlichkeitssuche, zu kleine reißen Zusammenhänge auseinander. Auch die reine semantische Suche hat Grenzen — für exakte Begriffe, Zahlen oder Eigennamen ist oft eine Kombination mit klassischer Stichwortsuche sinnvoll. Datenschutzrechtlich gilt: Auch aus Embeddings können sich Rückschlüsse ergeben, weshalb sensible Inhalte sorgfältig behandelt werden müssen, wie unter Datenschutz bei KI-Tools beschrieben.
Für Anwender bleibt vieles davon unsichtbar: Sie merken nur, dass eine Suche oder eine Empfehlung erstaunlich treffsicher ist. Genau darin liegt die Stärke von Embeddings — sie arbeiten im Hintergrund und machen Systeme spürbar intelligenter, ohne dass der Nutzer die Technik dahinter kennen muss.
Semantische Suche mit Embeddings
Der praktische Kern vieler Embedding-Anwendungen ist die semantische Suche. Dabei wird die Suchanfrage ebenfalls in ein Embedding umgewandelt und mit den gespeicherten Vektoren verglichen. Als Ähnlichkeitsmaß dient häufig die Kosinus-Ähnlichkeit, die den Winkel zwischen zwei Vektoren misst — je kleiner der Winkel, desto ähnlicher der Inhalt.
Anders als die klassische Stichwortsuche findet die semantische Suche auch Treffer, die dieselbe Bedeutung mit anderen Worten ausdrücken. Das macht sie robust gegen Synonyme und Umschreibungen. In der Praxis kombiniert man beide Verfahren oft, weil exakte Begriffe, Zahlen und Eigennamen weiter von der Stichwortsuche profitieren.
Diese Technik ist die Grundlage moderner Wissenssysteme: Sie liefert die passenden Textstellen, die ein Sprachmodell dann zu einer Antwort verarbeitet — das Prinzip hinter belegbasierten KI-Systemen und der KI-Suche.
Bei der Umsetzung lohnt ein pragmatischer Start: mit einem etablierten Modell und einer überschaubaren Wissensbasis beginnen, die Qualität messen und schrittweise ausbauen. So lässt sich der Nutzen früh belegen, bevor größere Investitionen in Infrastruktur nötig werden.
Embeddings auswählen und betreiben
Bei der Auswahl eines Embedding-Modells zählen Qualität, Sprache, Kosten und Vektorgröße. Für deutschsprachige Inhalte sollte das Modell Deutsch gut abbilden; große Vektoren sind genauer, aber teurer in Speicherung und Suche. Anbieter dokumentieren die Optionen in ihren Entwickler-Ressourcen, etwa in der OpenAI-Dokumentation oder bei Google.
Im Betrieb ist Konsistenz entscheidend: Alle Inhalte eines Systems müssen mit demselben Modell eingebettet werden, sonst sind die Vektoren nicht vergleichbar. Wechselt man das Modell, müssen alle Embeddings neu berechnet werden. Ein durchdachtes Vorgehen und gepflegte Datenqualität zahlen sich hier unmittelbar aus.
Schließlich sind Embeddings ein Baustein, kein Selbstzweck: Ihren Wert entfalten sie erst im Zusammenspiel mit einer Vektordatenbank und einer Anwendung wie einem KI-Chatbot für Websites oder einem Empfehlungssystem.
Embeddings gehören damit zu den stillen Grundlagen moderner KI: selten sichtbar, aber überall wirksam, wo es um Bedeutung und Ähnlichkeit geht. Von der Website-Suche über Empfehlungen bis zu belegbasierten KI-Antworten bilden sie die Brücke zwischen menschlicher Sprache und maschinenlesbaren Zahlen. Wer versteht, wie sie funktionieren, erkennt die Möglichkeiten und Grenzen vieler KI-Anwendungen deutlich klarer — und trifft bessere Entscheidungen beim Aufbau eigener Systeme.