Retrieval Augmented Generation (RAG) ist ein Verfahren, bei dem ein KI-Sprachmodell vor der Antwort relevante Informationen aus einer externen Wissensquelle abruft und in seine Antwort einbezieht. Statt nur auf Trainingsdaten zu vertrauen, greift das Modell auf aktuelle Dokumente, Datenbanken oder Websites zu. RAG macht KI-Antworten aktueller, überprüfbarer und deutlich weniger anfällig für Halluzinationen.
Was ist Retrieval Augmented Generation?
Retrieval Augmented Generation (RAG) ist ein Verfahren, bei dem ein KI-Sprachmodell vor der Antwort relevante Informationen aus einer externen Wissensquelle abruft und in seine Antwort einbezieht. Statt nur auf Trainingsdaten zu vertrauen, greift das Modell auf aktuelle Dokumente, Datenbanken oder Websites zu. RAG macht Antworten aktueller, überprüfbarer und deutlich weniger anfällig für Halluzinationen. Das Konzept geht auf eine Forschungsarbeit von 2020 zurück.
Der Ansatz verbindet die Stärke generativer KI — flüssige, kontextbezogene Sprache — mit der Verlässlichkeit einer belegbaren Quelle. Damit ist RAG die technische Grundlage vieler Unternehmensanwendungen, von der internen Wissenssuche bis zum KI-Chatbot für Websites. IBM ordnet das Verfahren in einem Fachbeitrag ein.
Wie funktioniert RAG Schritt für Schritt?
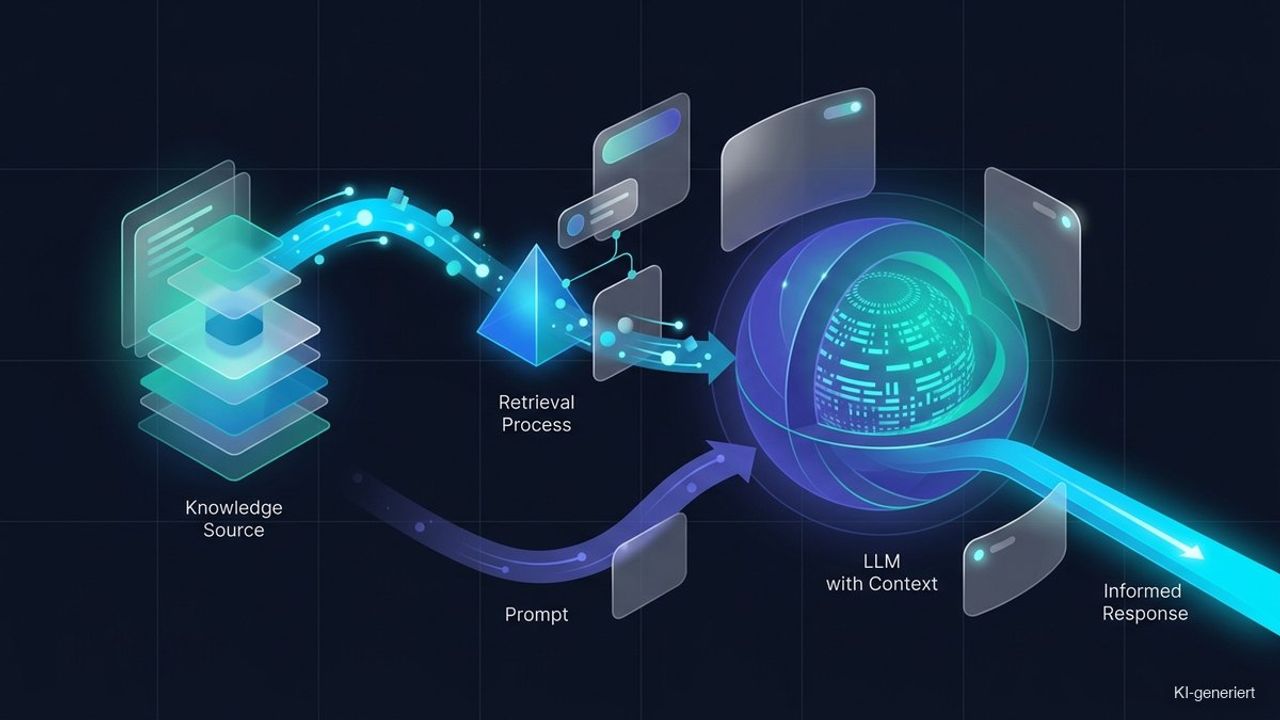
RAG kombiniert zwei Phasen. Zuerst sucht ein Retrieval-System zur Nutzerfrage passende Textstellen aus einer Wissensbasis — etwa Firmendokumenten, FAQ-Sammlungen oder einer Fachdatenbank. Die Dokumente werden dafür vorab in Abschnitte zerlegt und als Embeddings gespeichert, die eine inhaltliche Ähnlichkeitssuche über semantische Suche ermöglichen. Verwaltet werden diese Vektoren meist in einer Vektordatenbank.
Im zweiten Schritt erhält das große Sprachmodell die gefundenen Textstellen zusammen mit der Frage als Kontext und formuliert daraus eine Antwort. Das Modell antwortet also nicht aus dem Gedächtnis, sondern auf Basis der mitgelieferten Belege. Weil die Quelle bekannt ist, lässt sich die Antwort mit Verweisen versehen — ein Prinzip, das auch die KI-Suche nutzt. Die deutsche Wikipedia fasst den Ablauf zusammen.
Die Qualität des ersten Schritts, des Abrufs, bestimmt die Qualität der gesamten Antwort. Findet das System die falschen oder gar keine passenden Stellen, hilft auch das beste Sprachmodell nicht weiter. Deshalb steckt in einem guten RAG-System viel Arbeit in der Aufbereitung und Prüfung der Wissensbasis.
Warum ist RAG so wichtig?
Reine Sprachmodelle haben zwei Schwächen: Ihr Wissen endet mit dem Trainingsstand, und sie können Fakten erfinden. RAG behebt beides, indem es aktuelle, geprüfte Inhalte zur Laufzeit einbindet. Für Unternehmen ist das entscheidend, weil geschäftskritische Auskünfte auf verlässlichen Quellen beruhen müssen — etwa bei Produktdetails, Preisen oder rechtlichen Hinweisen.
Ein weiterer Vorteil ist die Nachvollziehbarkeit: Weil das System die verwendeten Belege kennt, kann es sie zitieren. Das schafft Vertrauen und erleichtert die Halluzinationsprüfung. Gleichzeitig bleibt sensibles Wissen im eigenen Haus, was RAG zu einer datenschutzfreundlicheren Alternative macht als das Nachtrainieren eines Modells mit vertraulichen Daten — ein Aspekt, den auch Datenschutz bei KI-Tools betrifft.
Der wirtschaftliche Reiz von RAG liegt in der Kombination aus Aktualität und Kontrolle: Unternehmen behalten ihre Inhalte im eigenen Haus, aktualisieren sie unabhängig vom Modell und bestimmen selbst, welche Quellen einbezogen werden. Das ist besonders dort wertvoll, wo sich Informationen häufig ändern oder wo Vertraulichkeit zählt.
RAG in der Praxis
Typische Anwendungen sind interne Assistenten, die Mitarbeitenden Fragen zu Handbüchern und Richtlinien beantworten, sowie kundenorientierte Systeme im KI-Kundenservice. Auch Custom GPTs nutzen RAG-ähnliche Mechanismen, um Antworten an hinterlegte Dokumente zu binden. In komplexeren Aufbauten kombiniert ein KI-Agent RAG mit weiteren Werkzeugen, um mehrstufige Aufgaben zu lösen.
Der Erfolg hängt stark von der Datenaufbereitung ab: Gut geschnittene Textabschnitte, saubere Quellen und eine durchdachte Ähnlichkeitssuche entscheiden über die Qualität. Schlechte oder veraltete Dokumente führen zu schlechten Antworten — das Prinzip „Müll rein, Müll raus” gilt uneingeschränkt. Deshalb ist Datenqualität eine zentrale Voraussetzung für funktionierendes RAG.
Ein typisches Einsatzszenario ist die Support-Automatisierung: Ein System durchsucht Handbücher und Tickets, findet die passende Stelle und formuliert daraus eine Antwort samt Quellenverweis. Mitarbeitende sparen Recherchezeit, und Kunden erhalten schneller belastbare Auskünfte.
Grenzen und typische Fehler
RAG beseitigt Halluzinationen nicht vollständig: Findet das Retrieval keine passenden Belege oder wählt es falsche Stellen aus, kann das Modell trotzdem daneben liegen. Auch widersprüchliche Quellen bereiten Probleme, weil das Modell nicht zuverlässig bewerten kann, welche Aussage korrekt ist. Eine sorgfältige Pflege der Wissensbasis ist deshalb Daueraufgabe, nicht Einmalprojekt.
Ein häufiger Fehler ist zu grobes oder zu feines Zerlegen der Dokumente: Zu große Abschnitte verwässern die Trefferauswahl, zu kleine reißen Zusammenhänge auseinander. Ebenso wichtig ist die Absicherung gegen Prompt Injection, wenn Inhalte aus unkontrollierten Quellen stammen. Wer RAG produktiv einsetzt, sollte die Ergebnisqualität laufend messen und die Wissensbasis systematisch aktualisieren.
Ein oft übersehener Vorteil ist die Erklärbarkeit: Weil das System die verwendeten Quellen kennt, kann es Nutzern zeigen, worauf eine Antwort beruht. Das erleichtert die Prüfung und schafft Vertrauen, gerade in Bereichen mit hohen Genauigkeitsanforderungen.
RAG im Vergleich zu anderen Ansätzen
Um ein Sprachmodell mit eigenem Wissen zu versorgen, gibt es mehrere Wege. Das aufwendige Nachtrainieren (Fine-Tuning) verändert das Modell dauerhaft, ist teuer und muss bei jeder Änderung wiederholt werden. RAG dagegen bindet Wissen erst zur Laufzeit ein und bleibt dadurch flexibel und aktuell. Für die meisten Unternehmensanwendungen ist RAG deshalb der pragmatischere Ansatz.
Ein dritter Weg ist, alle Informationen direkt in den Prompt zu schreiben. Das funktioniert bei kleinen Mengen, stößt aber an Grenzen, sobald die Wissensbasis wächst. RAG umgeht das, indem es zu jeder Frage nur die passenden Ausschnitte über semantische Suche heraussucht — ein Vorgehen, das auch die KI-Suche prägt.
In der Praxis kombinieren viele Systeme die Ansätze: ein leicht angepasstes Modell für Ton und Format, RAG für aktuelle Fakten. Entscheidend ist, dass die Wissensbasis gepflegt bleibt und die Datenqualität stimmt.
Der Aufwand für den Aufbau lohnt sich vor allem dann, wenn dieselben Fragen häufig auftreten und die zugrunde liegenden Informationen sich ändern. Für seltene oder rein kreative Aufgaben ist der Zusatznutzen dagegen gering — hier spielt das Modell seine Stärken auch ohne Wissensanbindung aus.
RAG richtig aufbauen und betreiben
Ein funktionierendes RAG-System entsteht in mehreren Schritten: Dokumente sammeln und bereinigen, sinnvoll in Abschnitte zerlegen, als Embeddings in einer Vektordatenbank speichern und die Trefferauswahl testen. Jeder Schritt beeinflusst die Endqualität, weshalb sich ein iteratives Vorgehen mit Messung lohnt.
Im Betrieb ist die Aktualität die größte Herausforderung: Ändern sich Produkte, Preise oder Richtlinien, muss die Wissensbasis mitgezogen werden, sonst antwortet das System veraltet. Ein fester Aktualisierungsprozess und Stichprobenprüfungen sichern die Verlässlichkeit — Teil einer durchdachten KI-Governance.
Sicherheit gehört ebenfalls dazu: Stammen Inhalte aus unkontrollierten Quellen, drohen manipulierte Anweisungen im Sinne einer Prompt Injection. Klare Grenzen zwischen Anweisung und Daten sowie eine Beschränkung auf vertrauenswürdige Quellen beugen dem vor.
Zusammengefasst ist RAG heute der praktischste Weg, generative KI mit verlässlichem, aktuellem Wissen zu verbinden. Es senkt das Fehlerrisiko, macht Antworten belegbar und hält sensible Daten im eigenen Haus. Der Erfolg steht und fällt jedoch mit der Pflege der Wissensbasis: Nur wer Quellen aktuell, sauber und gut strukturiert hält, erhält verlässliche Ergebnisse. Damit ist RAG weniger ein einmaliges Technikprojekt als eine dauerhafte Aufgabe an der Schnittstelle von Inhalt, Datenpflege und KI.