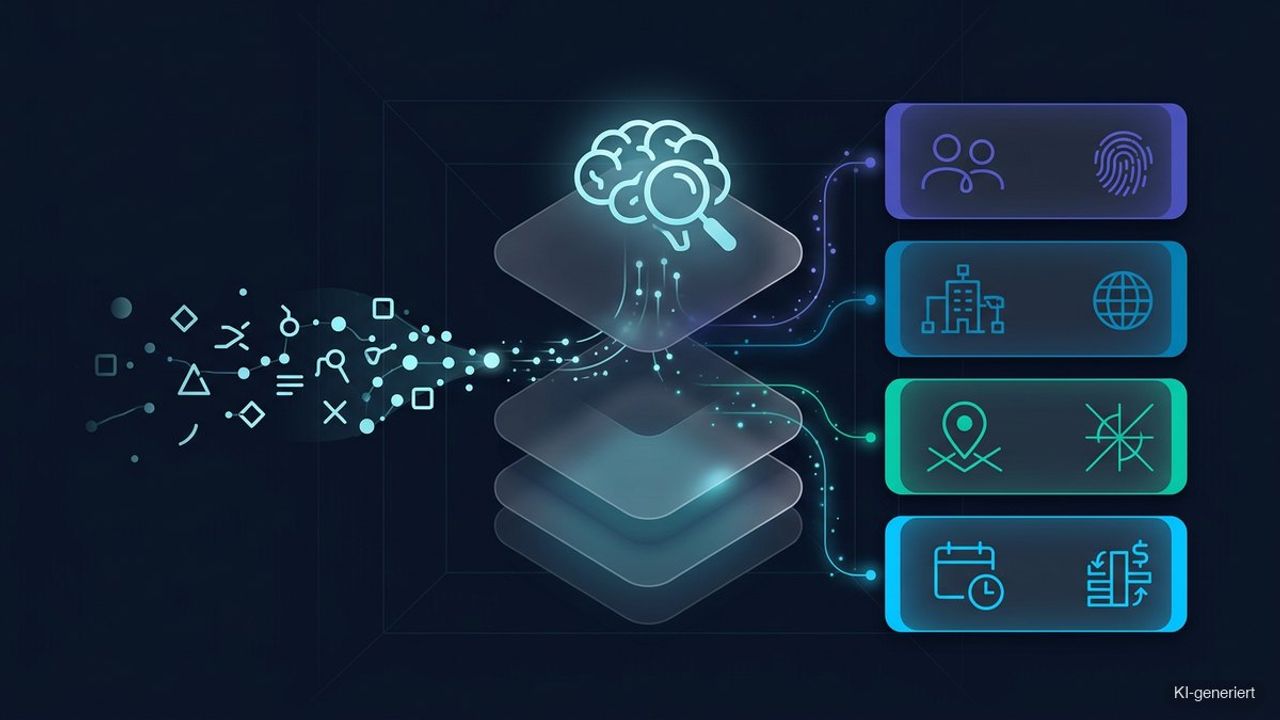
Named Entity Recognition (NER) ist ein Verfahren der Sprachverarbeitung, das benannte Entitäten in Texten erkennt und einordnet – etwa Personen, Organisationen, Orte, Daten oder Geldbeträge. Ein NER-System liest einen Text und markiert automatisch, welche Wörter zu welcher Kategorie gehören. So werden aus unstrukturiertem Fließtext strukturierte Informationen, die sich weiterverarbeiten lassen.
Was ist Named Entity Recognition?
Named Entity Recognition (NER), auf Deutsch Eigennamenerkennung, ist ein Verfahren der Sprachverarbeitung, das benannte Entitäten in Texten erkennt und einordnet — etwa Personen, Organisationen, Orte, Daten oder Geldbeträge. Ein NER-System liest einen Text und markiert automatisch, welche Wörter zu welcher Kategorie gehören. So wird aus unstrukturiertem Fließtext strukturierte Information, die sich weiterverarbeiten lässt. Fachlich zählt NER zur Informationsextraktion, wie das Nachschlagewerk zu NER beschreibt.
NER ist damit ein Grundbaustein moderner Textanalyse. Es steht am Übergang von der reinen Zeichenkette zur maschinell verstehbaren Bedeutung und liefert die Rohstoffe für Anwendungen wie Suche, Verschlagwortung und Wissensaufbau. Ohne NER bliebe ein Großteil der weltweit verfügbaren Information in unstrukturierter Form unzugänglich.
Historisch hat sich NER von regelbasierten Systemen über statistische Modelle bis zu neuronalen Netzen entwickelt. Frühe Ansätze arbeiteten mit handgeschriebenen Regeln und Wörterbüchern, moderne nutzen den Kontext ganzer Sätze. Diese Entwicklung ist eng mit der Computerlinguistik verbunden, die die sprachlichen Grundlagen liefert, auf denen maschinelle Erkennung überhaupt aufsetzt.
Wie funktioniert Named Entity Recognition?
Ein NER-Modell analysiert einen Text Wort für Wort im Zusammenhang und entscheidet, ob und zu welcher Kategorie ein Ausdruck gehört. „Dr. Meyer“ wird als Person erkannt, „Kaiserslautern“ als Ort, „OMmatic GmbH“ als Organisation. Moderne Systeme nutzen dabei den Kontext: Ob „Essen“ die Stadt oder die Mahlzeit meint, ergibt sich aus dem umgebenden Satz. Die englischsprachige Referenz zu Named-entity recognition beschreibt die gängigen Kategorien und Bewertungsmaße.
Technisch basieren aktuelle NER-Systeme meist auf trainierten Sprachmodellen und maschinellem Lernen, die aus vielen Beispielen gelernt haben, wie Entitäten aussehen. Bibliotheken wie spaCy stellen fertige Modelle bereit; die Dokumentation zu linguistischen Merkmalen zeigt, wie erkannte Entitäten mit Kategorie und Position im Text ausgegeben werden. Das Ergebnis ist eine strukturierte Liste, die sich programmatisch weiterverarbeiten lässt.
Technisch liefert ein NER-System nicht nur die Kategorie, sondern auch die genaue Position im Text und häufig einen Konfidenzwert. Diese Zusatzinformation ist entscheidend für die Weiterverarbeitung: Sie erlaubt es, unsichere Erkennungen zu markieren, mehrdeutige Fälle zu prüfen und die Ergebnisse in strukturierte Formate zu überführen, die sich in Datenbanken oder Wissensgraphen einspeisen lassen.
Wozu dient NER? Anwendungen in der Praxis
NER steckt in vielen Alltagsanwendungen. Suchmaschinen nutzen es, um Anfragen und Inhalte besser zu verstehen und mit dem Knowledge Graph zu verknüpfen. E-Mail-Programme erkennen Termine und Kontakte, Analysewerkzeuge zählen Marken oder Personen in großen Textmengen, und im Social Listening hilft NER, Nennungen automatisch zuzuordnen. Der Fachbeitrag zu NER nennt weitere typische Einsatzfelder.
Auch beim Aufbau von Wissensdatenbanken ist NER zentral: Es löst relevante Begriffe heraus und macht sie als Entitäten adressierbar. In Kombination mit Sentimentanalyse und Textklassifikation entstehen so Pipelines, die aus rohen Dokumenten belastbare Kennzahlen und Zusammenhänge gewinnen — etwa welche Organisation in welchem Zusammenhang und mit welcher Stimmung genannt wird.
Der praktische Wert von NER liegt in der Skalierung. Was ein Mensch bei einzelnen Dokumenten leistet, erledigt ein NER-System über Millionen von Texten in Sekunden. Damit wird Information erschließbar, die sonst im Verborgenen bliebe — etwa Marken- oder Personennennungen über den gesamten Nachrichtenstrom hinweg, ausgewertet in Kombination mit Web-Analyse und weiteren Datenquellen.
NER im Kontext moderner KI
Mit dem Aufstieg großer Sprachmodelle hat sich NER gewandelt. Ein Large Language Model kann Entitäten häufig ohne spezielles Training erkennen, allein aus dem Sprachverständnis heraus. Für viele Aufgaben genügt heute ein passender Prompt, statt ein eigenes Modell zu trainieren. Das senkt die Einstiegshürde erheblich.
Gleichzeitig bleiben spezialisierte NER-Modelle relevant, wo Tempo, Kosten und Verlässlichkeit zählen. Sie arbeiten schneller und günstiger als große Modelle, liefern konsistente Kategorien und lassen sich lokal betreiben. In der Praxis ergänzen sich beide Ansätze — feste Modelle für die Masse, Sprachmodelle für schwierige oder seltene Fälle. NER liefert dabei oft die strukturierte Grundlage für Retrieval-Augmented-Generation.
Im Zusammenspiel mit generativer KI wird NER zunehmend zum Werkzeug hinter den Kulissen. Bei Retrieval-Augmented-Generation hilft die Erkennung von Entitäten, relevante Dokumente gezielt zu finden und Antworten mit Belegen zu untermauern. So verbindet NER die klassische Textanalyse mit modernen KI-Agenten, die auf verlässliche, strukturierte Eingaben angewiesen sind.
Ein anschauliches Beispiel ist die Auswertung von Kundenrückmeldungen. Aus tausenden Bewertungen erkennt ein NER-System automatisch, welche Produkte, Standorte oder Mitarbeiter genannt werden, und macht diese Nennungen zählbar. In Verbindung mit einer Textklassifikation entsteht so ein präzises Bild davon, worüber Kunden sprechen — eine Grundlage, die manuell kaum in vergleichbarer Tiefe zu gewinnen wäre.
Grenzen und typische Fehler
NER ist nicht fehlerfrei. Mehrdeutige Namen, Tippfehler, seltene Eigennamen und ungewöhnliche Schreibweisen führen zu Verwechslungen. Ein Modell, das auf Nachrichtentexten trainiert wurde, schneidet auf juristischen oder medizinischen Fachtexten oft schlechter ab — die Domäne der Trainingsdaten prägt die Qualität stark.
Auch die Kategoriengrenzen sind nicht immer eindeutig: Ist eine Behörde eine Organisation oder ein Ort? Solche Grauzonen erfordern klare Konventionen. Für sensible Anwendungen empfiehlt sich deshalb eine Kontrolle durch einen Menschen in der Schleife, bevor die extrahierten Daten weiterverarbeitet werden.
Die Qualität steht und fällt mit der Passung von Modell und Anwendungsfall. Ein auf Nachrichten trainiertes System scheitert oft an Fachsprache, während ein domänenspezifisch trainiertes Modell in seinem Gebiet glänzt, außerhalb aber schwächelt. Für den produktiven Einsatz empfiehlt sich deshalb eine Evaluation an echten Beispieltexten, statt sich auf allgemeine Genauigkeitsangaben zu verlassen.
Bedeutung für Unternehmen und Kanzleien
Für Unternehmen ist NER der Hebel, um aus vorhandenen Dokumenten, E-Mails und Bewertungen strukturierte Informationen zu gewinnen — etwa für Automatisierung, Reporting oder eine bessere interne Suche. Wer große Textmengen ordnen muss, spart mit NER erhebliche manuelle Arbeit.
Gerade in datenintensiven Bereichen wie Kanzleien oder im Legal Tech hilft NER, Akten, Verträge und Schriftsätze zu erschließen. Dabei sind Datenschutz und Sorgfalt entscheidend, weil personenbezogene Daten im Spiel sind. Sauber eingesetzt, macht NER unstrukturiertes Wissen erstmals systematisch nutzbar.
Für Unternehmen ist NER selten Selbstzweck, sondern Teil einer größeren Automatisierung. Es speist Suche, Verschlagwortung und Reporting und macht unstrukturierte Bestände erstmals systematisch nutzbar. Wo personenbezogene Daten betroffen sind, gehört der Datenschutz zwingend dazu — die extrahierten Entitäten sind oft genau jene Informationen, die die DSGVO besonders schützt.
Mit Blick auf die Zukunft verschmilzt NER zunehmend mit anderen Bausteinen der Sprachverarbeitung. In modernen Pipelines arbeitet es Hand in Hand mit semantischer Suche und generativen Modellen, die auf strukturierte Eingaben angewiesen sind. Die Erkennung von Entitäten bleibt dabei das verbindende Element, das rohe Sprache in adressierbare, weiterverwendbare Information übersetzt. Damit bleibt die Eigennamenerkennung auch im Zeitalter großer Sprachmodelle ein unverzichtbares Werkzeug, das Ordnung in unstrukturierte Textmengen bringt. Ihr eigentlicher Wert liegt weniger in der Technik selbst als in den Anwendungen, die erst durch verlässlich erkannte Entitäten möglich werden.