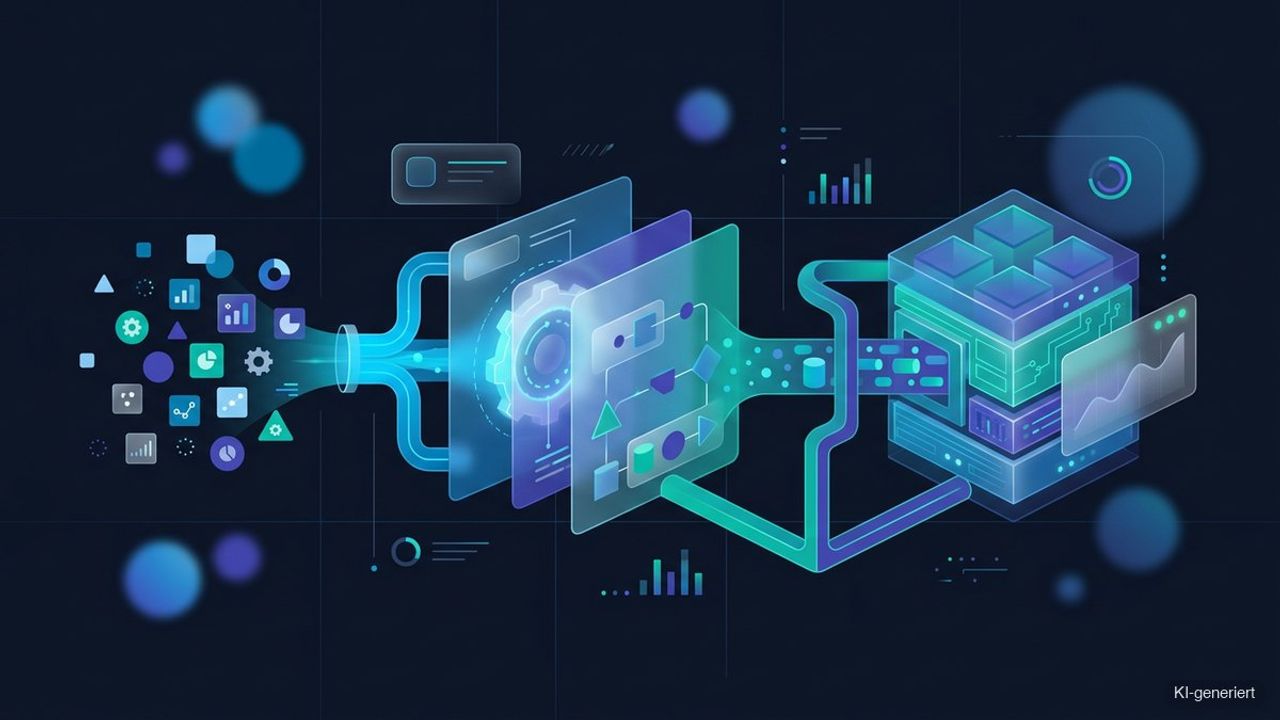
Ein ETL-Prozess (Extract, Transform, Load) beschreibt das Extrahieren von Daten aus Quellsystemen, ihre Umwandlung in ein einheitliches Format und das Laden in ein Zielsystem wie ein Data Warehouse. Er ist die technische Grundlage, um verstreute Daten zusammenzuführen und für Analysen nutzbar zu machen. ETL sorgt dafür, dass Daten sauber, konsistent und auswertbar ankommen.
Was ist ein ETL-Prozess?
Ein ETL-Prozess (Extract, Transform, Load) beschreibt das Extrahieren von Daten aus Quellsystemen, ihre Umwandlung in ein einheitliches Format und das Laden in ein Zielsystem wie ein Data Warehouse. Er ist die technische Grundlage, um verstreute Daten zusammenzuführen und für Analysen nutzbar zu machen. Der ETL-Prozess in der deutschsprachigen Wikipedia ordnet das Verfahren als klassischen Baustein der Datenintegration ein.
Das Grundproblem, das ETL löst, ist Vielfalt: Daten aus CRM, Werbeplattformen und Web-Analyse liegen selten in gleicher Form vor. Unterschiedliche Formate, Bezeichnungen und Zeitzonen machen einen direkten Vergleich unmöglich. Der ETL-Prozess harmonisiert diese Daten, sodass eine konsistente, auswertbare Basis entsteht — die Voraussetzung für belastbares Reporting.
ETL ist damit weniger ein einzelnes Werkzeug als ein Ablaufmuster. Es sorgt dafür, dass Daten sauber, konsistent und auswertbar im Zielsystem ankommen. Ohne diesen Schritt bliebe die Datenlandschaft ein Flickenteppich, aus dem sich kaum verlässliche Erkenntnisse gewinnen lassen — ein zentrales Anliegen jeder Datenstrategie.
Wie läuft ein ETL-Prozess ab?
Der Prozess besteht aus drei Schritten. Beim Extrahieren werden Daten aus den Quellsystemen ausgelesen, oft über eine API oder einen vorgefertigten Konnektor. Beim Transformieren werden diese Daten bereinigt, vereinheitlicht und in eine passende Struktur gebracht — etwa durch das Entfernen von Dubletten, das Angleichen von Formaten oder das Berechnen neuer Kennzahlen. Genau hier entsteht die Datenqualität, auf die spätere Auswertungen angewiesen sind.
Im dritten Schritt, dem Laden, werden die aufbereiteten Daten in das Zielsystem geschrieben, meist ein Data Warehouse wie BigQuery. Von dort stehen sie für Dashboards, Berichte und weitergehende Analysen bereit. Der Prozess läuft in der Regel automatisiert und in festen Intervallen, etwa täglich oder stündlich, und mündet häufig in Werkzeuge wie Looker Studio.
Eine Variante ist ELT (Extract, Load, Transform), bei der Rohdaten zuerst geladen und erst im Zielsystem transformiert werden. Moderne Cloud-Data-Warehouses mit hoher Rechenleistung begünstigen diesen Ansatz, wie auch die Übersicht von Google Cloud zum Thema ETL erläutert. Der Vorteil: Die Rohdaten bleiben erhalten und lassen sich später für neue Fragestellungen anders aufbereiten.
Warum ist ein ETL-Prozess wichtig?
Datengetriebenes Marketing steht und fällt mit der Verfügbarkeit sauberer, kanalübergreifender Daten. Ein verlässlicher ETL-Prozess ist die Voraussetzung dafür, Kampagnen aus Google, Meta und weiteren Quellen in einer gemeinsamen Sicht zu vergleichen. Erst diese Zusammenführung ermöglicht eine sinnvolle datengetriebene Attribution über Kanalgrenzen hinweg.
Gerade die Transformationsstufe ist entscheidend, denn hier werden Fehler bereinigt und Regeln durchgesetzt. Eine unbereinigte Datenbasis führt zu falschen Schlüssen und Fehlentscheidungen. Für die Business Intelligence und die automatisierte Berichtserstellung ist ein stabiler ETL-Prozess deshalb kein technisches Detail, sondern ein Qualitätsfundament.
Hinzu kommt die Skalierbarkeit. Manuelles Zusammenkopieren von Daten funktioniert bei kleinen Mengen, bricht aber zusammen, sobald mehrere Quellen und tägliche Aktualisierungen ins Spiel kommen. Ein automatisierter ETL-Prozess nimmt diese Arbeit ab und schafft die Grundlage für Predictive Analytics und komplexere Auswertungen.
Der ETL-Prozess in der Praxis
In der Praxis übernehmen spezialisierte Werkzeuge und Cloud-Dienste das Anbinden der Quellen und das Ausführen der ETL-Schritte, oft mit vorgefertigten Konnektoren für gängige Marketing-Tools. Das reduziert den Programmieraufwand erheblich und macht die Datenintegration auch für kleinere Teams zugänglich, die keine eigene Entwicklungsabteilung haben.
Wichtig ist, die Transformationsregeln klar zu dokumentieren und die Prozesse zu überwachen. Fällt eine Quelle aus oder ändert ein Anbieter seine Datenstruktur, kann der Prozess stillschweigend fehlerhafte oder unvollständige Daten liefern. Automatisierte Prüfungen und Benachrichtigungen bei Auffälligkeiten helfen, solche Probleme früh zu erkennen, bevor sie in Berichte einfließen.
Auch das Zusammenspiel mit First-Party-Daten gewinnt an Bedeutung. Da Drittanbieter-Daten zunehmend wegfallen, rücken eigene, direkt erhobene Daten in den Mittelpunkt. Ein sauberer ETL-Prozess führt diese eigenen Datenquellen zusammen und macht sie zur verlässlichen Grundlage für Analysen und Optimierung — ein Kern jeder modernen Datenbank-Optimierung.
Häufig ist der ETL-Prozess die Vorstufe für weitergehende Auswertungen wie eine Kohortenanalyse oder die Anreicherung mit benutzerdefinierten Dimensionen. Erst wenn Daten aus Google Analytics 4 und weiteren Quellen sauber zusammengeführt sind, lassen sich solche Analysen verlässlich rechnen. Der ETL-Prozess liefert dafür die konsistente Grundlage, auf der komplexere Fragestellungen überhaupt erst tragfähig werden.
Typische Fehler und Grenzen
Ein häufiger Fehler ist, die Transformationsregeln zu unbedacht zu formulieren. Werden Kennzahlen falsch berechnet oder Formate ungenau angeglichen, entstehen Auswertungen, die plausibel aussehen, aber falsch sind. Solche Fehler sind besonders tückisch, weil sie oft erst spät auffallen — wenn Entscheidungen bereits darauf beruhen.
Auch die Abhängigkeit von externen Schnittstellen ist eine Grenze. Ändert ein Anbieter seine Datenstruktur oder drosselt den Zugriff, kann der Prozess stocken. Eine Datenvisualisierung ist immer nur so gut wie die Daten dahinter; ein instabiler ETL-Prozess untergräbt jede noch so schöne Auswertung. Regelmäßige Kontrollen und ein aufmerksames Datensampling helfen, Verzerrungen zu erkennen.
Schließlich ist der Datenschutz zu beachten. Werden personenbezogene Daten verarbeitet, müssen Rechtsgrundlage, Speicherdauer und Zugriffsrechte geregelt sein. Der Grundgedanke einer sauberen Datenbank — strukturierte, kontrollierte Speicherung — gilt hier ebenso für die Rechtssicherheit wie für die technische Qualität.
ETL im Kontext moderner Datenarchitekturen
Der ETL-Prozess ist Teil einer größeren Datenarchitektur, die von der Erhebung über die Speicherung bis zur Auswertung reicht. In modernen Aufbauten verschwimmt die klare Trennung von ETL und ELT, und Werkzeuge übernehmen zunehmend beide Muster je nach Anforderung. Entscheidend ist nicht die Reihenfolge der Buchstaben, sondern das Ergebnis: verlässliche, auswertbare Daten.
Für Marketing-Teams bedeutet das, den ETL-Prozess als strategisches Fundament zu verstehen, nicht als reine Technik. Wer seine Datenflüsse sauber aufsetzt, kann schneller auf Fragen antworten, Kampagnen kanalübergreifend bewerten und automatisierte Berichte aufbauen. Die Investition in eine solide Datenintegration zahlt sich über jede spätere Analyse aus.
Der Blick nach vorn zeigt einen klaren Trend: Je mehr Entscheidungen auf Daten beruhen, desto wichtiger wird die verlässliche Zusammenführung dieser Daten. Ein gut gepflegter ETL-Prozess ist damit weniger ein einmaliges Projekt als eine dauerhafte Aufgabe — ein lebendiger Teil der Dateninfrastruktur, der mit den Quellen und Anforderungen mitwächst.
Im Zusammenspiel mit Server-Side-Tracking gewinnt der ETL-Gedanke zusätzlich an Bedeutung, weil Daten schon bei der Erhebung serverseitig kontrolliert und vereinheitlicht werden. Für übergreifende Modelle wie das Marketing-Mix-Modeling ist eine konsistente, sauber aufbereitete Datenbasis ohnehin Voraussetzung. Der ETL-Prozess ist damit nicht nur ein technischer Zwischenschritt, sondern die Brücke zwischen roher Datenerhebung und belastbarer, kanalübergreifender Entscheidungsgrundlage. Je konsequenter dieser Schritt automatisiert und überwacht wird, desto verlässlicher sind am Ende alle darauf aufbauenden Berichte, Dashboards und Prognosen. Der ETL-Prozess ist damit kein einmaliges Projekt, sondern eine dauerhafte Aufgabe, die mit neuen Quellen und Anforderungen stetig mitwächst und die Qualität jeder darauf gestützten Auswertung unmittelbar bestimmt.