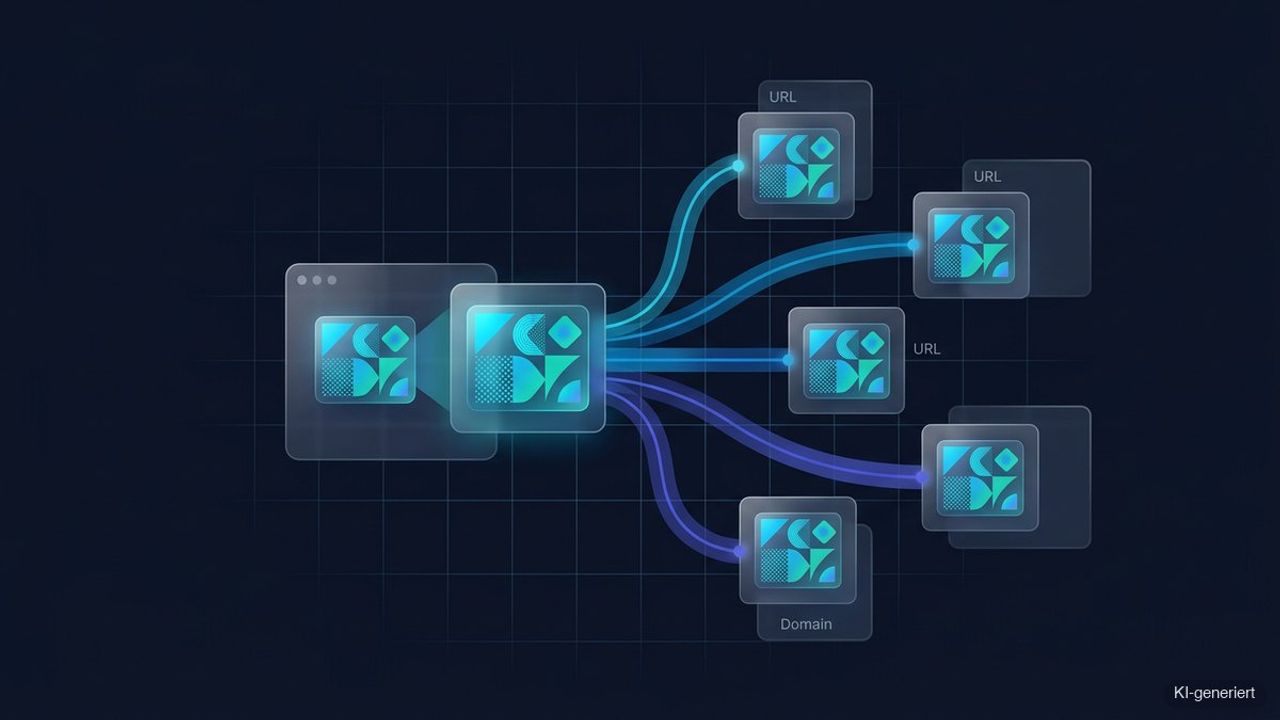
Duplicate Content bezeichnet identische oder sehr ähnliche Inhalte, die unter mehreren URLs erreichbar sind — innerhalb einer Website oder über verschiedene Domains hinweg. Suchmaschinen wollen pro Inhalt nur eine Version anzeigen und müssen bei Duplikaten entscheiden, welche URL rankt. Das führt selten zu einer Strafe, aber häufig zu verschenktem Potenzial, weil sich Rankingsignale auf mehrere Varianten verteilen.
Was ist Duplicate Content?
Duplicate Content bezeichnet identische oder sehr ähnliche Inhalte, die unter mehreren URLs erreichbar sind — innerhalb einer Website oder über verschiedene Domains hinweg. Suchmaschinen möchten pro Inhalt möglichst nur eine Version anzeigen und müssen bei Dubletten entscheiden, welche URL sie in den Index aufnehmen und ranken. Der Wikipedia-Artikel zu Duplicate Content fasst die technischen und inhaltlichen Ursachen kompakt zusammen und unterscheidet dabei zwischen internen und externen Dubletten.
Wichtig für das Verständnis: Duplicate Content ist selten ein Straf-, sondern meist ein Effizienzproblem. Rankingsignale wie Backlinks verteilen sich auf mehrere Varianten, statt sich auf eine starke Seite zu bündeln. Google beschreibt in der Dokumentation zum Zusammenführen doppelter URLs, wie sich Dubletten sauber auf eine kanonische Adresse konsolidieren lassen — der bevorzugte Weg, damit die Suchmaschine die richtige Version wählt.
Wie entsteht Duplicate Content?
Interner Duplicate Content entsteht meist technisch: dieselbe Seite mit und ohne www, mit http und https, mit Tracking-Parametern, als Druckversion oder über Filter- und Sortier-URLs in Shops. Jede dieser Varianten ist für Suchmaschinen eine eigene URL mit demselben Inhalt. Auch inhaltliche Ursachen sind verbreitet — etwa nahezu identische Standort- oder Leistungsseiten, bei denen nur der Ortsname ausgetauscht wurde. Solche Muster fallen im technischen SEO und bei einem Content-Audit auf.
Externer Duplicate Content liegt vor, wenn Inhalte auf mehreren Domains erscheinen: übernommene Herstellertexte in Shops, Pressemitteilungen auf vielen Portalen, kopierte Inhalte durch Dritte oder die Mehrfachverwendung eigener Texte auf Partnerseiten. Suchmaschinen versuchen dann, die Originalquelle zu identifizieren — was nicht immer gelingt und im ungünstigen Fall die fremde Kopie vor das eigene Original setzt. Gerade bei Standardtexten aus Herstellerkatalogen konkurrieren viele Shops mit identischem Wortlaut.
Warum ist Duplicate Content ein Problem?
Entgegen einem verbreiteten Mythos verhängt Google für gewöhnlichen Duplicate Content keine Strafe. Bereits 2008 stellte das Search-Team dies im Google-Beitrag zum Duplicate-Content-Mythos klar; abgestraft wird erst bewusst manipulatives Kopieren in großem Stil. Das eigentliche Problem ist subtiler: Die Suchmaschine wählt selbst eine Version aus, die Signale verteilen sich, und das Crawl-Budget wird mit Varianten verbraucht, statt neue oder aktualisierte Seiten zu erfassen.
Im Ergebnis rankt oft keine Variante so gut, wie es eine gebündelte Version könnte — oder es rankt die falsche, etwa eine Parameter-URL statt der sauberen Adresse. Für das Ranking bedeutet das verschenktes Potenzial. Bei kopierten Inhalten kommt hinzu, dass Nutzer im schlechtesten Fall die Kopie statt des Originals finden, wodurch die eigene Seite an Sichtbarkeit und Klicks verliert, obwohl sie die ursprüngliche Quelle ist.
Duplicate Content vermeiden und beheben
Das wichtigste Werkzeug ist das Canonical Tag: Es benennt die maßgebliche URL und bündelt die Signale der Varianten auf dieser einen Adresse. Dauerhafte Dubletten — etwa nach einem Domainwechsel — gehören per 301-Redirect umgeleitet; technische Varianten wie http/https und www/non-www sollten serverseitig auf eine einheitliche Version zusammengeführt werden. Interne Suchergebnis- und Filterseiten lassen sich per noindex aus dem Index halten, ohne dass sie für Nutzer verschwinden.
Inhaltlich gilt: Seiten, die sich nur in Details unterscheiden, besser zusammenführen oder substanziell differenzieren. Das betrifft etwa lokale Landingpages von Kanzleien und Unternehmen, die pro Ort echten lokalen Inhalt bieten sollten statt ausgetauschter Ortsnamen. Auch aussagekräftige, einzigartige Title-Tags helfen, Seiten klar zu unterscheiden. Grundsätzlich ist einzigartiger, für den jeweiligen Zweck geschriebener Inhalt der beste Schutz vor ungewollten Dubletten.
Duplicate Content bei internationalen und mehrsprachigen Seiten
Ein Sonderfall sind Websites mit mehreren Sprach- oder Länderversionen. Nahezu gleiche Inhalte für Deutschland, Österreich und die Schweiz sind kein klassischer Duplicate Content, wenn sie sich klar an unterschiedliche Zielgruppen richten. Damit Suchmaschinen die richtige Version ausspielen, kommt das hreflang-Attribut zum Einsatz, das Sprache und Region jeder Seite auszeichnet und die Versionen als Alternativen zueinander kennzeichnet.
Werden hreflang und Canonical widersprüchlich gesetzt, entstehen jedoch neue Probleme: Zeigt der Canonical einer österreichischen Seite auf die deutsche Version, kann die AT-Seite aus dem Index fallen. Sauberes Zusammenspiel beider Signale ist deshalb entscheidend. Grundsätzliche Hinweise dazu liefert Googles SEO-Starter-Leitfaden, der die Grundlagen der Indexsteuerung erklärt.
Duplicate Content prüfen und überwachen
Ob unerwünschte Duplikate indexiert sind, zeigt die Google Search Console im Indexierungsbericht — dort tauchen ausgeschlossene Varianten und alternative Seiten mit Canonical auf. Ergänzend geben Crawling-Tools Aufschluss darüber, welche URLs identische Inhalte ausliefern und wo Parameter unkontrolliert neue Adressen erzeugen. Regelmäßige Kontrolle lohnt vor allem bei Shops, Mehrsprachigkeit und nach einem Relaunch, wenn alte und neue URLs parallel existieren.
Wer Parameter, Filter und Paginierung sauber steuert und konsequent kanonisiert, hält die Indexierung schlank und lenkt die Kraft der Website auf die Seiten, die wirklich ranken sollen. Duplicate-Content-Management ist damit weniger eine einmalige Aufräumaktion als eine laufende Aufgabe, die bei jeder größeren Änderung an der Seitenstruktur erneut mitgedacht werden sollte.
Duplicate Content und KI-generierte Texte
Mit dem breiten Einsatz von KI-Content hat das Thema eine neue Facette bekommen. Werden mit denselben Vorgaben Texte für viele ähnliche Seiten erzeugt — etwa Produktbeschreibungen oder Standortseiten —, entstehen leicht nahezu austauschbare Inhalte, die sich nur in wenigen Wörtern unterscheiden. Für Suchmaschinen ist das faktisch Duplicate Content, auch wenn kein Wort wörtlich kopiert wurde. Entscheidend ist der Mehrwert: Bietet jede Seite eigene, für den konkreten Fall relevante Informationen?
Googles Bewertungsmaßstab ist die Nützlichkeit für Menschen, nicht die Frage, ob ein Text maschinell entstanden ist. Wer KI zur Skalierung nutzt, sollte die Ergebnisse deshalb redaktionell prüfen, mit eigenen Daten, Beispielen und lokalem Bezug anreichern und dünne, seriell erzeugte Seiten vermeiden. So bleibt der Inhalt einzigartig genug, um eigenständig zu ranken, statt in einer Masse ähnlicher Seiten unterzugehen.